
Grokkingとは? 訓練99%から27,400ステップ遅れて汎化した実験
「訓練データを完璧に覚えた時点で、学習は終わり」——普通はそう考える。ところが機械学習には、そこからさらに何万ステップも回し続けると、ある日突然テストデータでも解けるようになるという奇妙な現象がある。grokking(グロッキング、「腑に落ちる」の意)と呼ばれている。
陰陽の記事で目玉が450エポック無視され続けたのを見て以来、この本家の現象を自分の手で再現したかった。mod加算 を小さなMLPに学習させ、weight decayの強さを振って追いかけた。
実験に使ったコードの全文はGitHubに置いています。
何を「理解した」と呼んでいるのか
Grokkingは、訓練データに高精度で答えられるようになってから、遅れて未知データへの精度が改善する現象だ。Powerらの原論文は小規模なアルゴリズム課題でこの現象を報告している。ここでの「わかった」は人間の理解の比喩で、測っているのは未学習の組み合わせへの正解率である。
課題は「2つの整数を足し、53で割った余りを答える」。たとえば50と8なら、58を53で割った余りの5が正解になる。
| 項目 | 今回の設定 |
|---|---|
| 問題の総数 | 0〜52の順序付きペア、53² = 2,809問 |
| 訓練/テスト | 訓練1,123問、テスト1,686問(40%を切り捨て) |
| モデル | 各整数を96次元に埋め込み、連結 → 256ユニットReLU → 53クラス |
| 学習 | 全訓練データを使う更新、学習率0.001、最大60,000ステップ |
| 比較 | weight decayを0 / 0.03 / 0.1 / 0.3 / 1.0に変更 |
| 記録 | 初回と200ステップごと。訓練99%・テスト90%に達した記録時点を比較 |
元コードの設定を記した。単一シードの比較なので、以下の到達時刻はどの実行にも共通の待ち時間ではない。
結果:訓練99%からテスト90%まで27,400ステップ
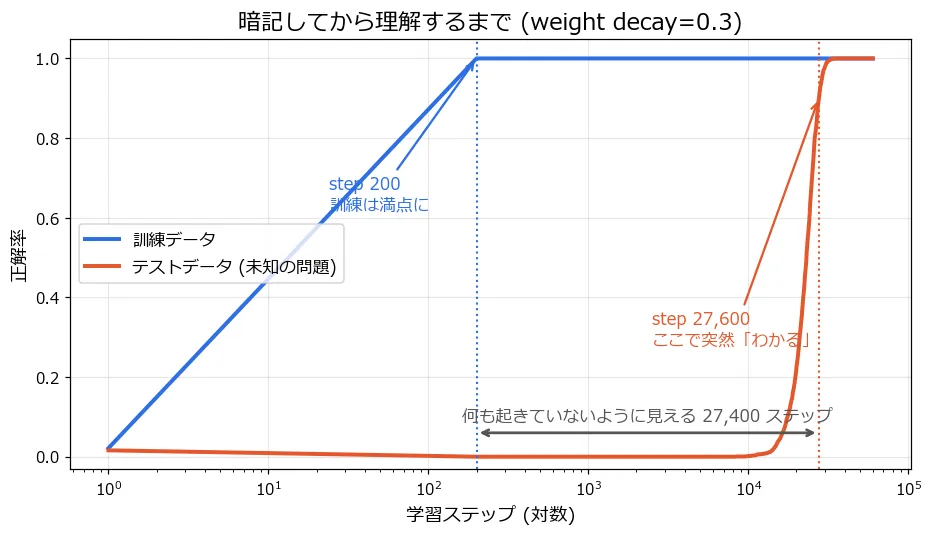
- step 200: 訓練精度が99%以上になった記録時点
- その後: テスト精度が低い期間が続く一方、後で見る重みノルムは変化している
- step 27,600: テスト精度が90%以上になった記録時点。最終テスト精度は1.000
2つの到達時刻の差が27,400ステップだ。99%を「満点」、90%到達の時刻を「100%になった瞬間」と読み替えないようにしたい。図は急な立ち上がりを示しているが、測定は200ステップ間隔なので、その間の細かな時刻までは特定していない。
失敗談: weight decayを1行間違えて、重みを全て0に潰した
正直に書くと、1回目の実験は完全な失敗だった。weight decayを勾配に足す形で実装したのだ。
g = g + wd * p       # 結合型L2。分離型weight decayとは異なる
mom = B1*mom + (1-B1)*g
p -= lr * mom_hat / (sqrt(vel_hat) + eps)この実装のwd=1.0では重みが極端に小さくなり、訓練精度2.6%(ほぼランダム)のまま4万ステップが終わった。Adamは勾配の移動平均と2乗の移動平均を使うため、L2項も適応的な更新に混ざる。同じ係数でも、重みを直接縮める操作とは等価ではない。 結合型L2そのものが常に誤り、あるいは必ず学習不能になるわけではない。
分離型weight decayは、損失の勾配とは別に重みを縮める。AdamWの原論文が扱うのはこの違いだ。標準的な更新の要点は次の形になる。
p *= (1 - lr * wd)
p -= lr * mom_hat / (sqrt(vel_hat) + eps)なお、今回の公開実験コードはこの2行が逆で、Adam更新後の重みを縮めている。この順序では勾配による更新量にも縮小がかかるため、標準的なAdamWと厳密には一致しない。下の数値は元の実装で得た結果として残した。標準実装との完全な再現比較は別途必要になる。
weight decayを変えると、60,000ステップ以内の結果が変わった
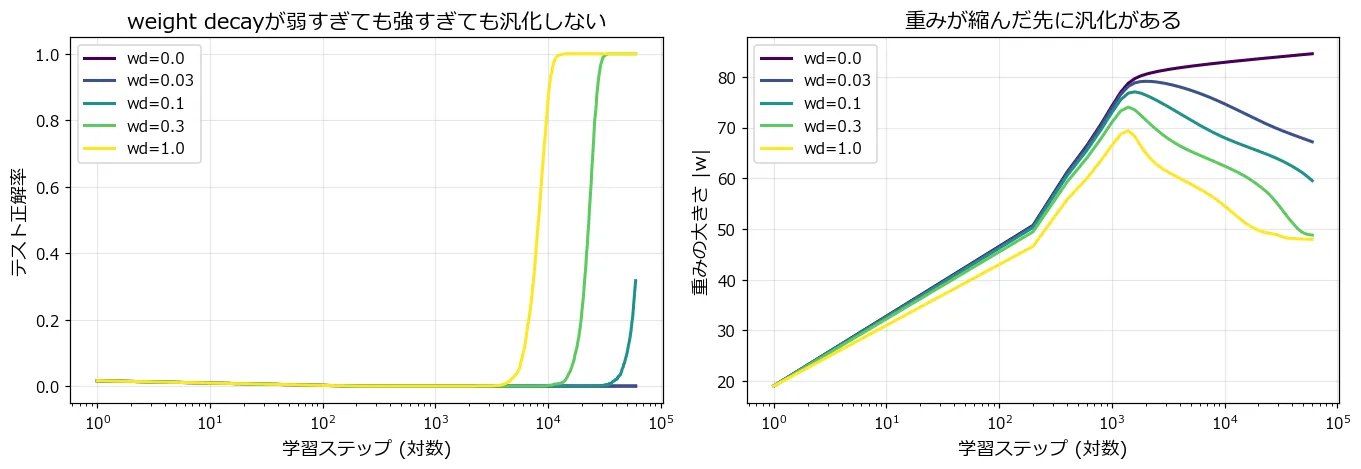
修正版で、weight decayを0から1.0まで5段階振った。
| weight decay | 訓練99%到達 | テスト90%到達 | 最終テスト精度 |
|---|---|---|---|
| 0.0 | step 200 | 到達せず | 0.000 |
| 0.03 | step 200 | 到達せず | 0.000 |
| 0.1 | step 200 | 到達せず | 0.317 |
| 0.3 | step 200 | step 27,600 | 1.000 |
| 1.0 | step 200 | step 10,400 | 1.000 |
訓練99%に達した記録時点は、どの条件もstep 200だった。wd=0と0.03は60,000ステップ以内にテスト90%へ届かず、wd=0.3より1.0のほうが早く届いた。これは今回の設定と観測期間の結果であり、もっと強くすれば必ず速くなる、あるいは弱ければ永久に汎化しないという法則ではない。
正解率が止まって見えても、重みは変わっている
重みの大きさとテスト精度を重ねると、正解率だけでは見えなかった変化が見える。
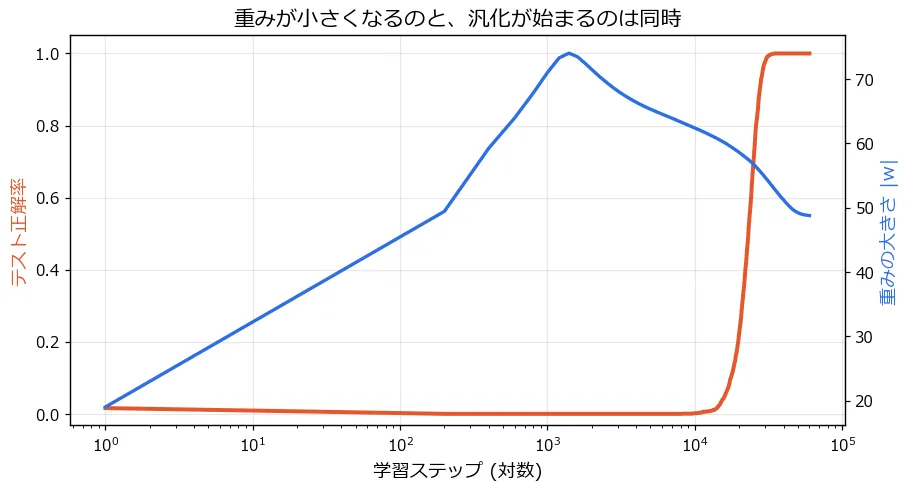
重みノルムはstep 1,400付近まで増え、その後は減少し、減少している途中でテスト精度が上がった。これが直接観測したことだ。
「暗記に使っていた表現が整理され、規則を表すようになった」という説明は魅力的だが、このグラフだけでは内部の計算方法までは証明できない。 それを確かめるには、学習途中のモデルを保存し、表現や回路の分析も必要になる。正解率は最大確率のクラスが変わるまで動かない一方、予測確率や損失、重みは連続的に変わりうる。
手を動かして意外だったこと
意外だったのは、訓練精度が高いのに、テスト精度が低い期間がこれだけ続くことだ。短い待ち時間のearly stoppingでは、この遅い立ち上がりを見逃す可能性がある。ただし、通常の学習で早期終了をやめればよい、という教訓にはならない。実務で設定や停止時刻を選ぶなら検証セットを使い、最終テストセットは評価のために残しておく。
陰陽の記事の「目玉が450エポック無視される」も、Q学習の「価値が1歩ずつしか遡らない」も、同じ形をしている。学習の内部では何かが進んでいるのに、外から見える数字は動かない期間がある。数字が動かないことは、何も起きていないことの証明にはならない。
自分で再現するときは、データ分割と初期値を固定してweight decayを比較し、その後シードを変えて再確認したい。精度と一緒に損失・重みノルムを保存すれば、「止まって見える」と「何も変わっていない」を区別できる。
まとめ
- mod加算で、訓練99%とテスト90%の到達記録に27,400ステップの差が出た
- 精度が停滞して見える間にも重みは変化しており、「何も起きていない」とは言えない
- 結合型L2と分離型weight decayはAdamでは等価でない。元コードの更新順序も標準AdamWとは異なる
- 試した条件ではwd=1.0が0.3より早くテスト90%に達した。最適値や到達時刻を一般化はできない
- 未知の問題を解けたことと、内部でどんな規則を学んだかの証明は別になる
学習曲線の読み方をもう少し確かめたい方は、過学習と正則化、二重降下の実験へ。高い訓練精度だけで学習の成否を判断できない点がつながってくる。
関連記事
このブログでは、機械学習の仕組みを実際にコードで実装して確かめた実験をテーマ別に整理しています(拡散モデル・Transformer・強化学習・多様体学習・過学習など)。