
中心極限定理は「n=30」で十分? 7つの分布で標本平均のズレを測った
アンケートを30人に取って平均を出す。「30あれば十分」という目安を、どこまで信用してよいのだろう。
標本サイズが30以上あれば、標本平均は正規分布に従うとみなしてよい。
中心極限定理を説明するときによく使われる目安だ。ただし、元の分布や、どの程度の近似誤差を許すかという条件も一緒に考える必要がある。Penn Stateの講義も、元の分布の形によって必要な標本サイズが変わることを説明している。
ただ、中心極限定理が言っているのは「無限に増やせば」の話だ。30は無限ではない。では30で何が起きているのか。
先に答えを書くと、30は一律の保証にはならない。 今回置いた「累積確率の最大のズレが0.01未満」という目安をn=30で満たしたのは、7分布中1つだった。ただし、これは本実験の比較基準であり、残り6つでt検定が使えないという判定ではない。
この記事では「平均の分布」「歪み」「飛び飛びの値」「極端な外れ値」を順に切り分ける。実験に使ったコードの全文はGitHubに置いています。
そもそも、何が正規分布に近づく話なのか
まずここを揃えておきたい。近づくのはデータそのものではない。
サイコロを30回振って、出た目の平均を出したとする。3.4だった。もう一度30回振って平均を出すと、今度は3.6かもしれない。3.1かもしれない。この「平均」自体が、やるたびに違う値になる。
この平均を2万回ぶん集めてヒストグラムを描くと、3.5あたりを山にした釣鐘型の分布ができる。中心極限定理が言っているのは、この「平均たちの分布」が正規分布(釣鐘型)に近づくということだ。サイコロの目そのものは1〜6が平らに出るだけで、いくら振っても釣鐘型にはならない。
言葉を3つだけ決めておく。
- 母集団 … 元のデータが従う分布(サイコロなら「1〜6が等確率」)
- 標本サイズ n … 1回の平均を作るのに使う個数(30回振るなら n=30)
- 標本平均 … その n 個の平均
なぜ形を気にするのか。平均の正規近似は、検定や信頼区間の近似を支えるからだ。ただし、t検定は標本平均だけでなく推定した標準誤差も使う。正規母集団なら小標本でも厳密なt分布を使え、非正規母集団では条件に応じて近似になる。平均の分布の見た目だけで、検定や信頼区間の正しさを判定できるわけではない。
測り方
母集団を7種類用意した。左右対称なものから、極端に歪んだものまで。
そこから n 個を取り出して平均する、を2万回繰り返す。集まった2万個の標本平均が、正規分布からどれだけ離れているかを測る。
ズレの尺度にはコルモゴロフ・スミルノフ統計量(KS統計量)を使った。名前は物々しいが、やっていることは単純だ。2つの分布について「x以下になる確率」のグラフを描いて重ね、いちばん離れている場所での差を取る。それだけ。
- KS = 0 … 完全に一致
- KS = 0.05 … どこかで「x以下になる確率」が5ポイントずれている
比較の目安は KS < 0.01 に置いた。累積確率のズレを1ポイント未満にしたい、という今回の選択だ。以下の「合格」はこの目安を満たすという意味で、一般に決まった実用基準ではない。
比較の前に、2万個の標本平均から平均と標準偏差を推定して、位置と広がりを揃えてある。コーシー分布だけは平均・分散が存在しないので、中央値と「四分位範囲 ÷ 1.3489795」で揃えた。
ここではKSを距離の指標として使う。同じデータから正規分布のパラメータを推定しているため、通常の1標本KS検定の棄却点をそのまま適用できない。この違いはSciPyの適合度検定の解説でも扱われている。また、2万回という有限回のシミュレーション自体にも揺らぎがある。「0.01未満だから正規性が証明された」という読み方はしないでほしい。
n = 30 で何が起きているか
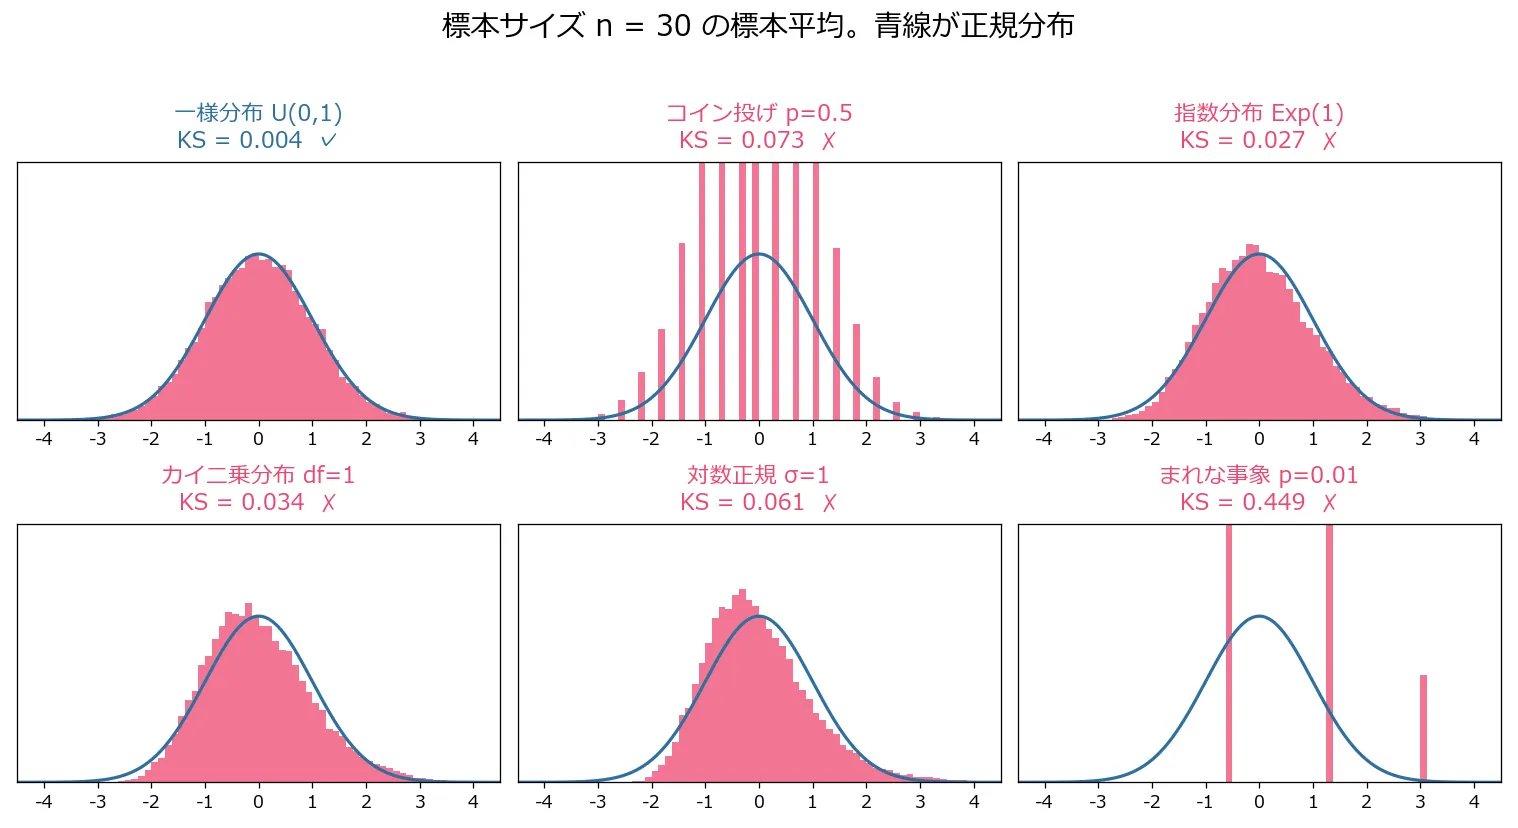
青い線が正規分布、ピンクの棒が実測した標本平均の分布だ。ぴたりと重なっているのは左上の一様分布だけで、あとはどれも形が違う。
| 母集団 | どんなデータか | n=30 の KS | 判定 |
|---|---|---|---|
| 一様分布 U(0,1) | 0〜1が平らに出る | 0.004 | 合格 |
| 指数分布 Exp(1) | 待ち時間。短いことが多く、たまに長い | 0.027 | |
| カイ二乗分布 df=1 | 指数分布よりさらに右に尾を引く | 0.034 | |
| 対数正規 σ=1 | 年収や売上。掛け算で増えるもの | 0.061 | |
| コイン投げ p=0.5 | 表か裏か、2つの値しか取らない | 0.073 | |
| コーシー分布 | 極端な外れ値が頻繁に出る | 0.081 | |
| まれな事象 p=0.01 | 100回に1回だけ起きる出来事 | 0.449 |
7つのうち、合格は1つ。
「まれな事象」の0.449は桁が違う。図の右下を見ると、棒が3本しか立っていない。100回に1回しか起きないことを30回試すと、ほとんどの回で0件、たまに1件、まれに2件。平均が取りうる値が数種類しかないので、なめらかな釣鐘型になりようがない。
n を増やすと、どう変わるか
n=30だけ見ても仕方がないので、1から1000まで動かした。
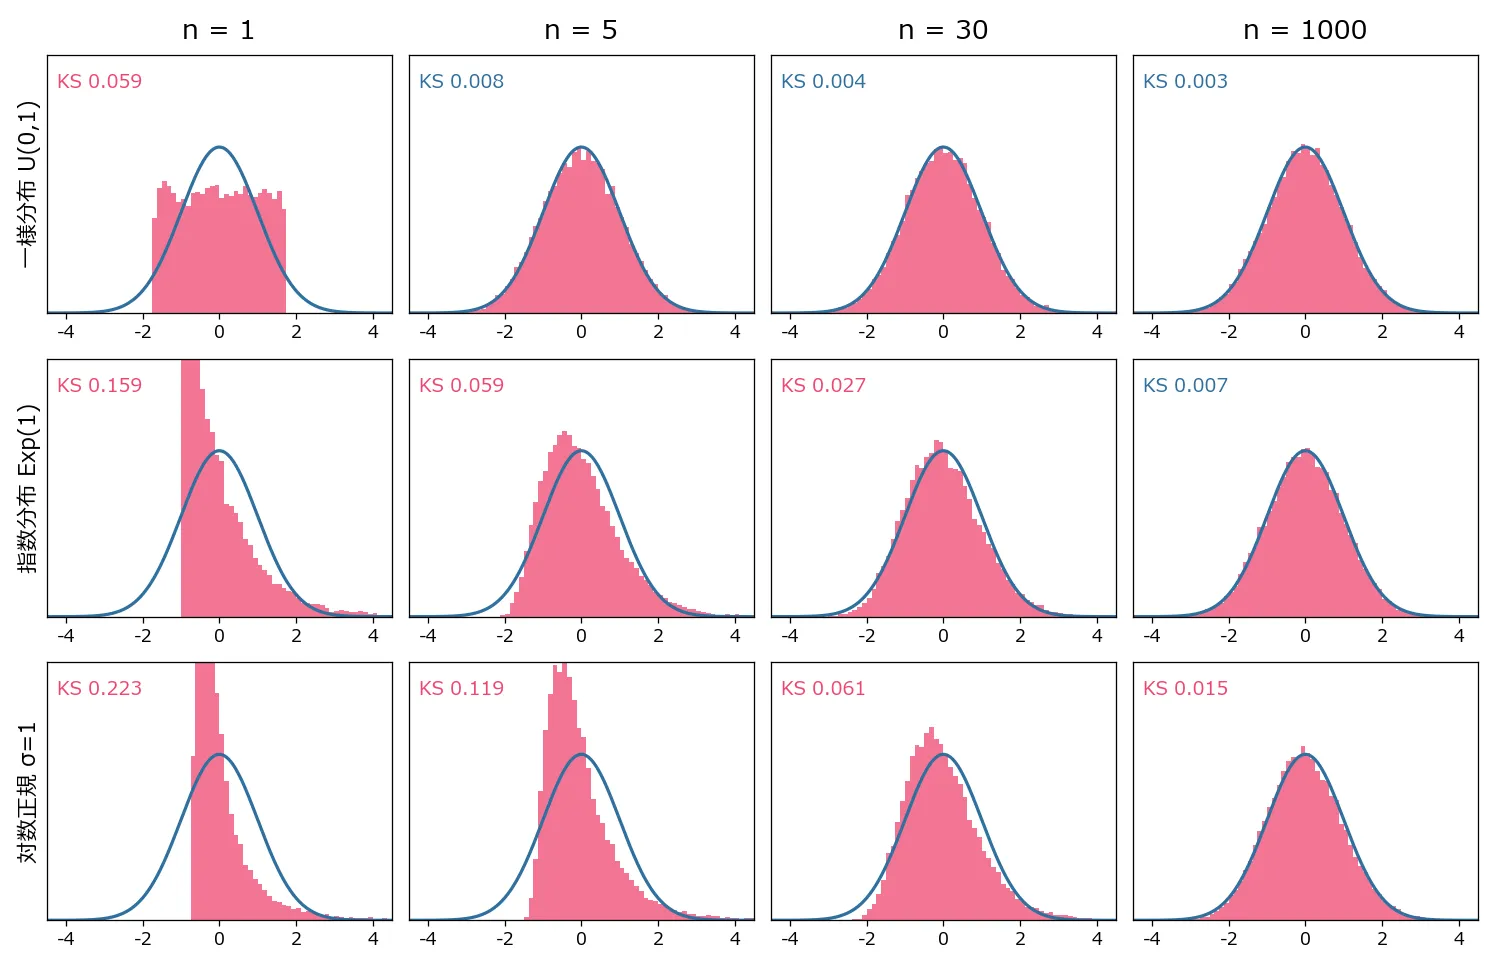
上の行(一様分布)は、n=1では四角い平らな形なのに、n=5でもう正規分布と見分けがつかない。
下の行(対数正規)は、n=1000まで行っても左に寄ったままだ。山の位置がずれていて、右に長い尾を引いている。
同じ「30」を当てはめる相手として、この2つは違いすぎる。
7分布すべてについて、ズレの縮み方を1枚にするとこうなる。
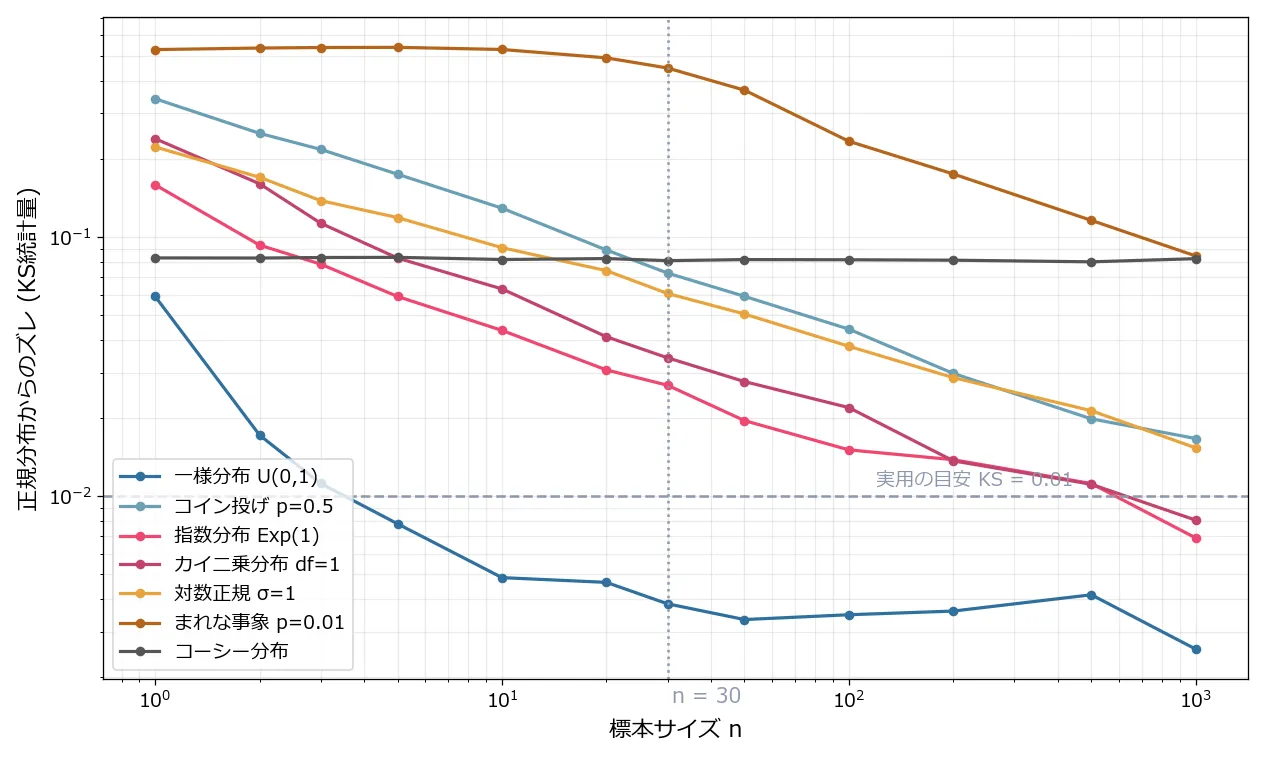
線が下にあるほど、この標準化と指標では正規分布に近い。横向きの破線は今回の目安(KS=0.01)。縦の点線が n=30 の位置だ。
| 母集団 | 調べたnの中で初めてKS < 0.01を満たした値 |
|---|---|
| 一様分布 U(0,1) | 5 |
| 指数分布 Exp(1) | 1000 |
| カイ二乗分布 df=1 | 1000 |
| 対数正規 σ=1 | 1000でも未達 |
| コイン投げ p=0.5 | 1000でも未達 |
| まれな事象 p=0.01 | 1000でも未達 |
| コーシー分布 | 到達しない |
一様分布はn=5で目安を下回り、指数分布は調べた値の中ではn=1000で初めて下回った。ただしnを1刻みで試したわけではないので、1000が必要最小数とは言えない。この表が示すのは、同じnでも、近似の精度は元の分布によって大きく違うことだ。
歪度は手がかり。ただし正規近似の合否は決められない
では何が2つを分けているのか。歪度(わいど)という量が効いている。
歪度は、分布が左右どちらに偏っているかを表す数字だ。
- 歪度 0 … 左右対称(正規分布、一様分布、コイン投げ)
- 歪度が大きい … 右に長い尾を引く。年収がこれ。多くの人が数百万円のあたりに固まっていて、右のほうにごく少数の高額所得者がいる
さっきの表を歪度の順に並べ直すと、KSの順とほぼ一致する。
| 母集団 | 歪度 | n=30 の KS |
|---|---|---|
| 一様分布 | 0.00 | 0.004 |
| 指数分布 | 2.00 | 0.027 |
| カイ二乗分布 df=1 | 2.83 | 0.034 |
| 対数正規 σ=1 | 6.18 | 0.061 |
| まれな事象 p=0.01 | 9.85 | 0.449 |
理論上、標本平均の歪度は次の式で減っていくことが知られている。
n個の平均を取ると、歪みが 分の1になる、という意味だ。実測がこの式に乗るか確かめた。
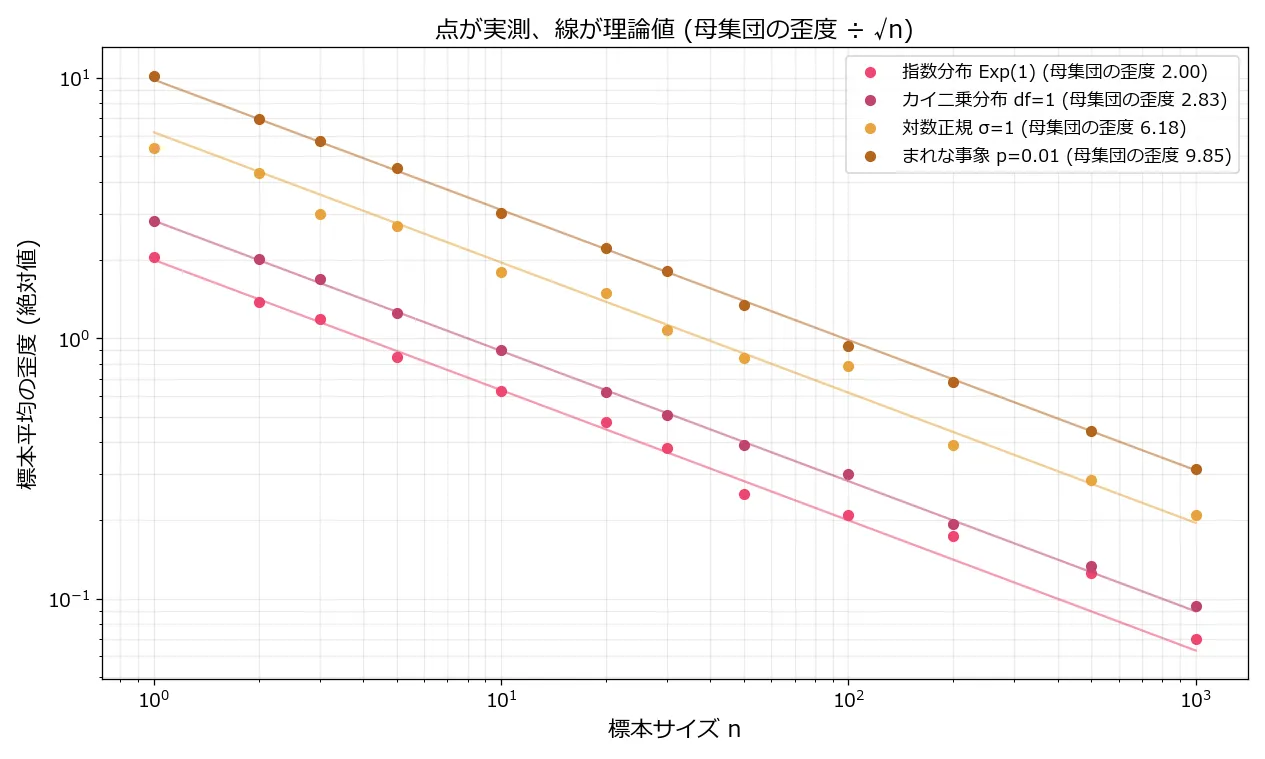
点(実測)が線(理論)に乗った。
独立同分布で、分散と3次の絶対モーメントが有限なら、この式が使える。標本平均の歪度の絶対値だけを0.1以下に抑える条件に書き直すと、
となる。これは歪度についての条件であり、KS < 0.01や信頼区間の精度を保証する式ではない。左右対称でも、裾が重かったり値が飛び飛びだったりする分布はある。
| 母集団 | 歪度(概数) | 歪度の条件だけから求めたnの目安 |
|---|---|---|
| 一様分布・コイン投げ | 0 | どのnでも歪度は0。正規性は別問題 |
| 指数分布 | 2.00 | 400 |
| カイ二乗分布 df=1 | 2.83 | 800 |
| 対数正規 σ=1 | 6.18 | 約3,826 |
| まれな事象 p=0.01 | 9.85 | 約9,701 |
逆算すると、n=30でこの歪度の条件を満たすのは母集団の歪度の絶対値が約0.55以下の場合だ。これは「歪度0.55以下なら正規近似してよい」という基準にはならない。
実務では母集団の歪度そのものも未知だ。売上や滞在時間のヒストグラムに長い右裾があれば、近似の精度を追加確認する理由になる。ただし小標本から推定した歪度は外れ値で大きく動くので、それだけを必要人数の計算機にしてはいけない。
真ん中が合っていても、端は合っていない
もうひとつ、見落としやすいところがある。
標準化した標本平均が を超えた割合を数えた。正規分布なら0.27%(1000回に約3回)になるはずの数字だ。
| 母集団 | n=30 での実測 | 正規分布の何倍 |
|---|---|---|
| 一様分布 | 0.27% | 1.0倍 |
| 指数分布 | 0.44% | 1.6倍 |
| カイ二乗分布 df=1 | 0.60% | 2.2倍 |
| 対数正規 σ=1 | 1.10% | 4.1倍 |
| コーシー分布(四分位範囲で換算した尺度) | 14.03% | 約52倍 |
対数正規の n=30 で、「3σの外」が正規分布の4倍出ている。「1000回に3回」のつもりが「100回に1回」ということだ。
この実験と同じ条件の標本平均に、正規近似に基づく3σの閾値を置けば、閾値を超える頻度を過小評価する。これは個々の売上データや、あらゆる異常検知の誤報率が4倍になるという意味ではない。
図で真ん中が合って見えても、端は別に確認したほうがいい。KS統計量は「いちばん離れている場所」を見る指標なので、確率の絶対量が小さい裾のズレは拾いにくいからだ。
コイン投げが合格しない理由は、歪みではない
表を見返すと、ひとつ変な行がある。コイン投げは歪度0(左右対称)なのに、n=30でKS=0.073。n=1000でも0.0167で合格しない。
理由は歪みではなく、飛び飛びの値しか取らないことだ。
n回のコイン投げの平均は という値しか取れない。n=30なら31通りしかない。「x以下になる確率」のグラフを描くと、なめらかな坂ではなく階段になる。相手の正規分布はなめらかな坂なので、段差ぶんのズレが必ず残る。
最初の図でコイン投げのパネルが櫛のように見えていたのは、これだ。
段差の大きさから計算すると、KSの下限はおよそ になる。n=1000で0.0126、実測0.0167とだいたい合う。0.01まで下げるには n≈1600 が要る計算だ。
つまりコイン投げも最後は正規分布に寄る。ただし寄り方が でしかない。「はい/いいえ」「クリックした/しなかった」のような2値データを扱っているかぎり、この段差はついて回る。
コーシー分布は、1000個平均しても何も変わらない
最後の1つは、これまでとは種類の違う壊れ方をする。
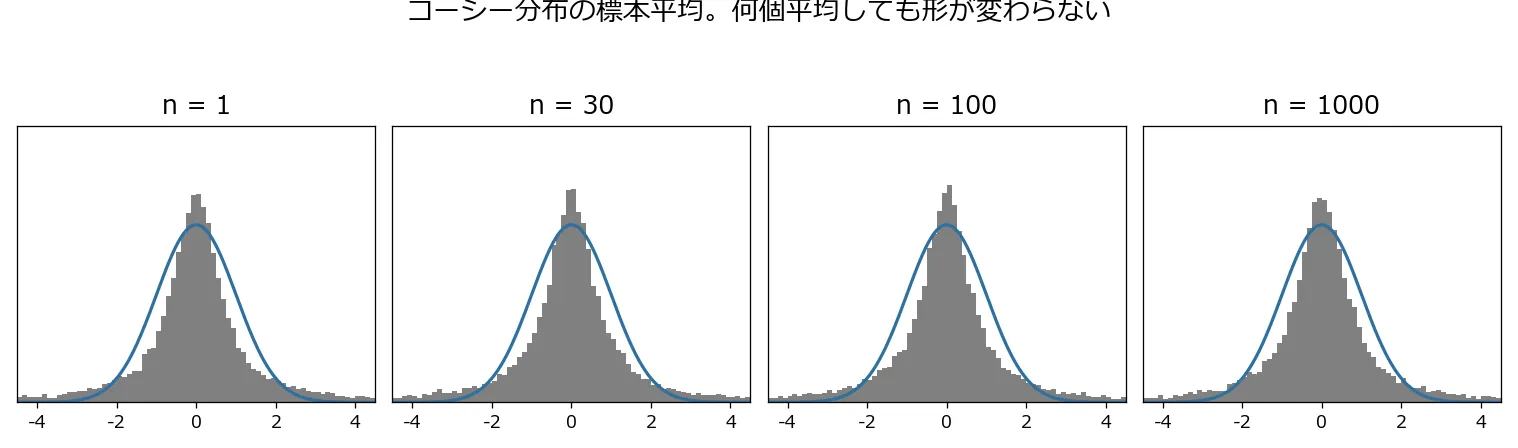
| n | 1 | 30 | 100 | 1000 |
|---|---|---|---|---|
| KS統計量 | 0.083 | 0.081 | 0.082 | 0.083 |
1000個平均しても、1個のときと同じ形だ。 縮みもしないし、釣鐘型にも近づかない。
理由は、コーシー分布に平均も分散も存在しないこと。「計算するのが難しい」のではなく、数学的に存在しない。極端な外れ値が出る確率が十分に高いので、データを増やすほど平均が暴れて、どこにも落ち着かない。
中心極限定理は「母集団に有限の平均と分散があること」を前提にしている。コーシーはその前提を満たさないので、定理の外側にいる。実際、コーシー分布から n 個取って平均すると、その分布は元のコーシー分布とぴったり同じになることが証明できる。平均という操作が、何も縮めていない。
表の14.03%は、中央値から「四分位範囲 ÷ 1.3489795」の3倍より外に出た割合だ。コーシー分布に標準偏差σはないので、これを文字どおりの「3σ」とは呼べない。正規分布の±3σの外側は約0.27%、約370回に1回。それと比べて約52倍の頻度だった。
この例は「平均を取れば必ず安定する」という直感への反例になる。現実のデータに大きな外れ値があるだけで、コーシー分布や分散無限と判定できるわけではない。NISTの分布解説でも、コーシー分布の平均・標準偏差は未定義とされている。
自分で動かしてみる
n を動かしたときに形がどう変わるかを触れるようにした。上のボタンで分布を切り替えられる。
一様分布はスライダーを2つ動かしただけで正規分布に張り付く。対数正規は1000まで動かしても左に寄ったままだ。コーシー分布は、どこまで動かしても何も起きない。
結局、どうすればいいのか
最初に決めるのは「何人いればよいか」より、何を、どの精度で知りたいかだ。
| 知りたいこと | 確認すること | 次に試すこと |
|---|---|---|
| 平均購入額の区間推定 | 裾の長さ、外れ値、顧客ごとの依存 | 想定分布で区間の被覆率をシミュレーションする |
| クリック率などの割合 | 総数に加え、成功数・失敗数 | 二項分布に基づく区間やWilson区間を検討する |
| 極端な値が出る頻度 | 分布の中央だけでなく裾 | 閾値付近の確率を直接確認する |
| A/Bテストで差を見つける | 検出したい差、ばらつき、検出力 | 実験前に標本数と停止ルールを設計する |
同じ人から30回取った測定と、独立な30人から取った測定も違う。この記事の実験は独立同分布を前提としている。
ブートストラップも、小標本に含まれなかった稀な極端値を作り出せるわけではない。中央値や順位に基づく方法へ変えるときも、知りたかった「平均」と同じ問いに答えているかを確認する。方法を替えるだけで、データ不足や依存が解消するわけではない。
まとめ
- 今回のKS < 0.01という目安をn=30で満たしたのは7分布中1つ。一様分布0.004、指数分布0.027、対数正規0.061、まれな事象p=0.01は0.449
- 歪度を0.1以下にする条件は。ただし正規近似の精度や、検定の可否を保証する式ではない
- 標本平均の歪度が で減ることは実測でも確認できた
- 中央が合っていても裾は合わない。対数正規のn=30で3σ超えが1.10%(正規の4.1倍)
- 2値データはKSに の下限が残る。コイン投げが歪度0なのに0.073なのはこれが理由
- コーシー分布はn=1000でもKS=0.083で、n=1から動かない。平均も分散も存在しないため定理の外側にいる
実際に形を比べるなら中心極限定理シミュレーターで一様分布と対数正規分布を同じnにしてみてほしい。「データを増やす」以外に、どの集団をまとめるかで結論が変わる例も読むと、平均を使う前に確認したい条件がつながる。
測った数字より、「30」という数がどう伝わってきたかのほうが気になった。
もとは「歪度が小さければ30程度で足りる」という条件付きの話だったはずだ。それが伝わるうちに条件が落ちて、数字だけが残った。数字だけになると強い。30は覚えやすいし、会議で「サンプルは30あります」と言えば議論が終わる。条件は思い出す手間がかかるが、数字は思い出す手間がかからない。 だから条件のほうが先に落ちる。
自分が人に何かを渡すときも、たぶん同じことをしている。「この条件のときは、この手順で」と伝えたつもりが、相手には手順だけが残る。そして条件の外側で使われて、うまくいかない。
条件が落ちても壊れない渡し方があるとすれば、条件を注釈ではなく手順そのものに埋め込むことだと思う。「n=30」ではなく「ヒストグラムを描いて、右に尾を引いていたら30では足りない」と言えば、条件と手順が分かれない。前者は覚えられて誤用され、後者は覚えるのが面倒でも、覚えた人は間違えない。
コーシー分布のほうは、もっと救いがない話だった。平均を取れば真ん中に寄る、というのは平均が存在する場合の話でしかない。存在しないものを1000回足して1000で割っても、存在しないままだ。 数を集めれば確からしくなる、と無条件に信じている場面が、自分にもある気がしている。
関連記事
このブログでは、機械学習の仕組みを実際にコードで実装して確かめた実験をテーマ別に整理しています(拡散モデル・Transformer・強化学習・多様体学習・過学習など)。