
FGSMとは? 敵対的サンプルのノイズを強くしても、誤分類が増え続けなかった理由
「ごくわずかな、人間の目にはほとんど気づけないノイズを画像に足すだけで、パンダを99%の自信でテナガザルだと誤分類させられる」——adversarial examples(敵対的サンプル)の話は、AIの安全性を語るときによく引き合いに出される。有名な例だとGoodfellowらのFGSM(Fast Gradient Sign Method)論文のパンダの画像がそれで、見た目はほぼ変わらないのに、モデルの確信度だけが完全にひっくり返る。
これを自分の手で確かめたことは一度もなかった。ただし今回やるのは、大きな画像分類モデルへの攻撃ではない。2次元の小さなtoyデータセットに、自分でスクラッチ実装したMLPを学習させ、そのMLPだけをFGSMで殴ってみる、という小規模でクリーンな再現実験だ。実運用の画像認識モデルがどうか、という主張はしていない。それでも「決定境界のすぐ近くにいる点は、本当にごくわずかな一押しで判定が反転するのか」という核心の部分は、この小さな実験でも十分に検証できる。
実験に使ったコードの全文はGitHubに置いています。
先に結果を書くと、この分類器への1ステップのFGSMでは、ノイズを強くしても誤分類の割合は増え続けなかった。 ただし、攻撃で反転しなかった点が「あらゆる攻撃に強い」と分かったわけではない。この記事の見どころは、その2つを分けて、入力が境界を横切る様子を追えるところにある。
two-moonsに97パラメータのMLPを学習させる
データはdropoutの記事でも使ったtwo-moons(ノイズ0.15、標準化してstd=1.0)。1000点を700(学習)/300(テスト)に分割し、2→24(tanh)→1(sigmoid)のMLPを、順伝播・逆伝播・Adamまで全部numpyで自前実装して4000エポック学習した。
初見の方のために、そもそも何をやらせているのかを先に書いておく。two-moonsは、2つの三日月(クレセント)型の点群が互い違いに噛み合うように並んだ2次元の人工データセットで、各点には「どちらの三日月から生成されたか」のラベル(class 0/class 1)が付いている。モデルの仕事は、座標(x1, x2)だけを見てこのラベルを当てる、ごく普通の2クラス分類だ——下の図で言えば、青い点群と赤い点群のあいだに境界線を引くこと。そして今回の攻撃側の「成功」は、もともと正しく分類されていた点の座標をほんの少しだけ動かして、この判定を誤りに変える(以降「反転」と呼ぶ)ことと定義する。
def forward(params, X):
    W1, b1, W2, b2 = params
    z1 = X @ W1 + b1
    h1 = np.tanh(z1)
    z2 = h1 @ W2 + b2
    out = sigmoid(z2).ravel()
return out, (X, z1, h1, z2)パラメータ数はたったの97個。それでもテスト精度は0.9833まで上がった。
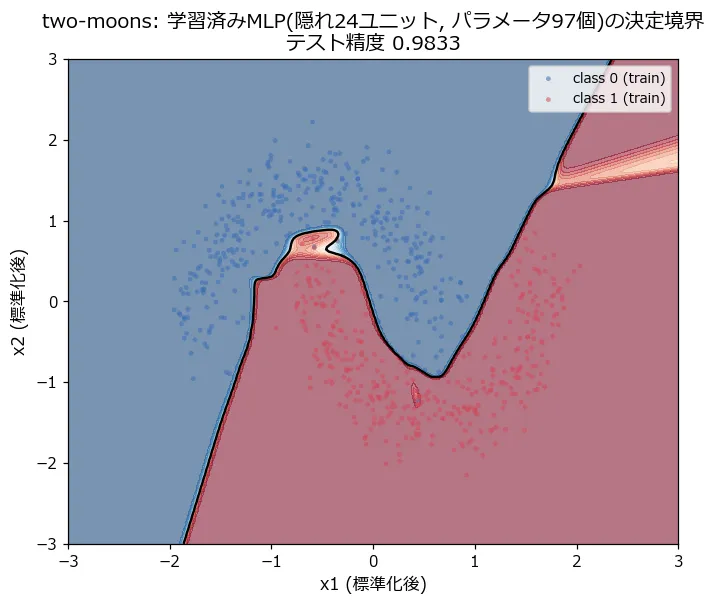
わずか97パラメータでも、境界は単純な直線ではなく、データの重なり具合に合わせて細かく波打っている。この「波打ち具合」が、あとでFGSMの挙動に効いてくる。
FGSM: 勾配の向きは「重み」ではなく「入力」について取る
通常の学習では、損失を重みについて微分して重みを更新する。FGSMはこれの逆で、損失を入力について微分し、その符号方向に入力そのものを動かす。
def grad_wrt_input(params, cache, y_true, out):
    """FGSMの核心: 重みではなく「入力X」についての dL/dX を計算する"""
    W1, b1, W2, b2 = params
    X, z1, h1, z2 = cache
    d_z2 = (out - y_true).reshape(-1, 1)   # 点ごと、平均しない
    d_h1 = d_z2 @ W2.T
    d_z1 = d_h1 * (1 - np.tanh(z1) ** 2)
    d_X = d_z1 @ W1.T                       # (n, 2) dL/dX
    return d_X
これで各点ごとに が求まる。あとは
の式どおり、符号だけを使って各点を摂動させる。FGSMは、各座標の変化量をε以下に制限する(制約)もとで、損失の一次近似を最大にする動かし方だ。勾配の大きさに比例して進む方法とは違い、各成分の符号を使う。Goodfellowらの原論文で提案された方法である。
たとえば入力が、損失の勾配が、ε=0.1なら、加えるのはで、移動後は。2次元で両成分が非ゼロなら、移動距離()はになる。ε=0.1を「平面上で0.1だけ動く」と読むと、尺度を取り違える。
テスト300点のうちもともと正しく分類されていた295点を攻撃対象にし、εを0から2.5まで0.01刻みで細かくスイープして、「もともと正解していた点のうち何%が誤分類に反転したか」(反転率)を実測した。
結果1: 反転率はε=0.26(stdの26%)で10%、ε=0.41で25%——ただし45%前後で頭打ち
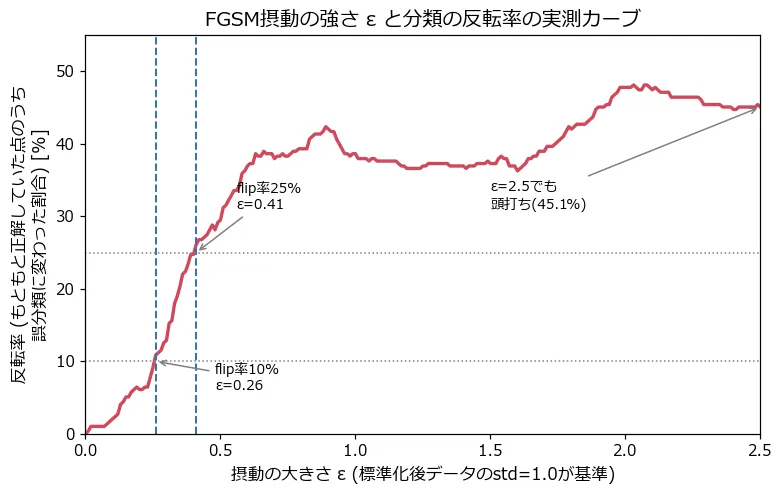
正直、予想していたのは「εを上げ続ければいずれ反転率はほぼ100%に近づく」という素直な右肩上がりのカーブだった。実際は違った。
- ε=0.05: 反転率 1.02%
- ε=0.10: 反転率 2.03%
- ε=0.20: 反転率 6.10%
- ε=0.26: 反転率が初めて10%を超える
- ε=0.30: 反転率 12.88%
- ε=0.41: 反転率が初めて25%を超える
- その先は単調ですらない。ε=0.9付近で42.4%まで上がったあと、ε=1.6にかけて36.3%まで一度下がり、ε=2.03でスイープ全体の最高値48.1%をつける
- ε=2.5(データの標準偏差2.5個分、もはや”微小”とはとても言えない大きさ)の終点では反転率45.08%。スイープ全体を通して、反転率は一度も50%に届かなかった
295点中111点(37.6%)は、調べたε=0〜2.5の0.01刻みの範囲では一度も反転しなかった。 2.5より先や、刻みの間、別の方向は、この結果だけでは分からない。
今回のFGSMは元の点で求めた符号方向を固定して進む。反転率が42%台から36%台へ下がった区間では、いったん誤分類された点の一部が正しいクラスの領域へ戻ったことになる。局所的な一次近似で選んだ方向が、遠くまで最も有効とは限らないのだ。
攻撃の成功率と、モデルの頑健さは違う
εが大きくなれば、攻撃者が選べる「各座標の変化がε以内」の領域は広がる。したがって、その領域内の最も悪いケースを探し切れれば、攻撃成功率は下がらない。小さいεで見つけた成功例を、そのまま使えるからだ。
一方、FGSMは各εで1つの候補を作るだけ。その候補が失敗することと、領域内に成功例が存在しないことは別になる。今回下がったのは、決まった方法で作った候補の成功率であって、最悪ケースへの弱さではない。
結果2: それでも境界のすぐ隣の点は、ε=0.01というごく小さな摂動で反転する
反転した184点について、調べた刻みの中で初めて反転したεを求めた。最も小さいものは0.010、中央値0.490、最大2.490だった。これは固定したFGSM方向で、離散的に探索した値だ。あらゆる方向を探した「境界までの最短距離」ではない。
- ε≦0.01で反転する点: 295点中1点(0.3%)
- ε≦0.05で反転する点: 295点中3点(1.0%)
- ε≦0.10で反転する点: 295点中6点(2.0%)
小さな摂動で反転する点も、今回の方向では反転しない点もあった。効き方には、境界までの距離だけでなく、攻撃方向と境界の形も関わる。反転しなかった点について「境界から遠い」とは断定できない。
εを10%反転率に達する0.26に固定し、実際にどの点がどう動いたのかを個別に見てみる。
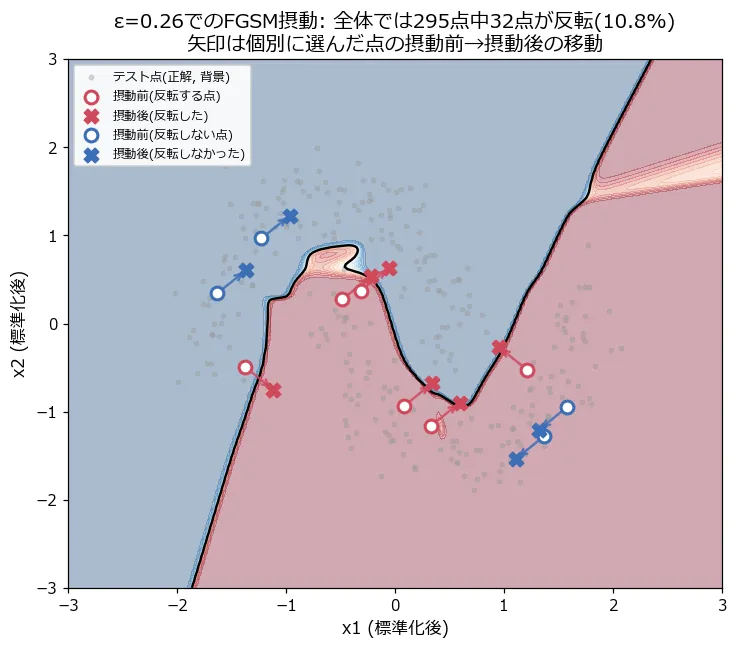
矢印は斜め45度を向いている。勾配の各成分が非ゼロならsignは±1なので、2次元の移動方向は4つの対角方向になる(ゼロ成分があれば例外)。今回の矢印の長さはで共通だ。同じ長さでも、その方向に境界があるか、途中で何回またぐかによって結果が変わる。
εを連続的に上げていくアニメーション
εを0から1.0まで連続的に上げながら、正解していた295点全体がどう動いていくかをGIFにした。
序盤はほとんど何も起きていないように見えるのに、εが上がるにつれて境界に近い点から順番に色を変えていく様子が見える。全員が一斉に動くのに、実際に「反対側に落ちる」のは境界のすぐそばにいた点だけ、というのがこのアニメーションで一番伝わってほしいところだ。
手を動かして意外だったこと
一番意外だったのは、ε=0〜2.5の探索で反転率が単調に増えず、最大でも48.1%だったことだ。攻撃の許容範囲を広げることと、良い攻撃候補を見つけることを、自分が同じものとして考えていたと気づいた。
もう1つは、境界のすぐそばの点がε=0.01という本当にわずかな摂動で反転していたこと。集計された反転率のカーブだけを見ていたら、この「ごく一部の点が信じられないほど脆い」という事実には気づけなかった。全体の反転率が10%を超えるにはε=0.26まで必要だったのに、最も脆い1点はその26分の1のεで既に落ちていた。平均的な頑健さと、最悪ケースの脆さは、まったく違う指標だということを実測して痛感した。
再現するときに分けて記録したいこと
| 記録するもの | なぜ必要か |
|---|---|
| 入力の尺度とε | 標準化後の0.1と、画像の画素値の0.1は違う |
| 攻撃前の正解数 | 今回の反転率の分母は300点ではなく295点 |
| 各εでの成功率 | 増減や、いったん戻る挙動を見つける |
| ε以下で一度でも成功した点の割合 | 過去の成功例を含めた結果を区別する |
| 探した方向・刻み・範囲 | 未探索の領域にまで結論を広げない |
さらに頑健性を調べるなら、勾配を更新しながら複数回進む攻撃や、異なる初期点からの探索との比較が必要だ。この実験ではそこまでは測っていない。通常のテスト精度と攻撃への強さを、別の評価項目として扱うところが出発点になる。
まとめ
- two-moonsデータ(1000点、標準化)に2→24(tanh)→1(sigmoid)、パラメータ97個のMLPを学習させ、テスト精度0.9833を達成した
- FGSM(損失の入力に対する勾配の符号方向に で摂動)を、正しく分類されていた295点に対して実施した
- 反転率(誤分類に変わった割合)はε=0.26で10%、ε=0.41で25%に達したが、ε=2.5(標準偏差2.5個分)まで上げても45%前後で頭打ちになり(最高でもε=2.03の48.1%で、50%には一度も届かなかった)、295点中111点(37.6%)は一度も反転しなかった
- 調べた中ではε=0.010で反転する点もあった。ただし、この値は最短の攻撃距離を保証しない
- FGSMの失敗は、他の攻撃も失敗する証拠にはならない。集計値と個々の点、攻撃の性能とモデルの頑健さを分けて読む必要がある
境界そのものがどう作られるかは、陰陽データでモデルの表現力を比べた記事で可視化している。評価方法の落とし穴を続けて読むなら、乱数から精度100%が出たデータリークの実験へ。
関連記事
このブログでは、機械学習の仕組みを実際にコードで実装して確かめた実験をテーマ別に整理しています(拡散モデル・Transformer・強化学習・多様体学習・過学習など)。