
データリークとは? 特徴選択の順番だけで乱数の精度が100%になった実験
「交差検証をしているのに、本番では全く当たらないモデル」の話は、機械学習をやっていれば一度は聞いたことがあると思う。原因としてよく挙げられるのがデータリーク——テストデータの情報が、何らかの形で訓練プロセスに漏れてしまうことだ。中でも有名なのが「特徴選択を交差検証の外でやってしまう」パターンで、マイクロアレイの遺伝子発現解析の時代から警告され続けている古典的な落とし穴だ(Ambroise & McLachlan, 2002)。
ただ、私はこの話をいつも「気をつけましょう」という標語としてしか知らなかった。実際にやらかしたとき、精度は何%水増しされるのか。データの次元数や選ぶ特徴の数で、その水増しはどう変わるのか。そして「前処理を全データでやるのもリーク」とよく言われるが、それは特徴選択のリークと同じくらい危険なのか。数字で見たことが一度もなかったので、真の信号が一切ないデータ——つまり純粋な乱数——を使って、幻の精度がどこまで出るのかを実測してみた。
実験に使ったコードの全文はGitHubに置いています。
先に結論:交差検証に渡すのは手順全体
テスト側の答えを使って特徴を選ぶと、その後で何分割しても情報は消えない。 問題集の答えを見て出題範囲を絞り、その範囲で抜き打ち試験を受けるようなものだ。
| 手順 | 検証用のラベルを特徴選択に使うか | 評価しているもの |
|---|---|---|
| 全データで特徴選択 → 交差検証 | 使ってしまう | 答えの情報が混ざった成績 |
| 分割 → 訓練側で特徴選択 → 検証側に適用 | 使わない | 未知のデータへの予測性能 |
実験では前者が20シードすべてで100%になった条件がある。後者はおおむね50%。直し方のコードは後半に載せたので、手元の実装を確認したい方は「Pipelineに入れる」の節から読んでもよい。
実験設計: 乱数の特徴と乱数のラベルから「当たる」モデルを作る
材料は2つだけ。n=100サンプル × p次元の標準正規乱数の特徴行列と、それとは完全に独立に生成したランダムな2値ラベルだ。ラベルは等確率なので、独立な未知データへの精度の期待値は0.5になる。ただし、有限個のテストでは偶然に0.5を超えることもある。そこで、同じデータ・分割で手順を比較し、複数シードで繰り返して、系統的な水増しを確かめた。
このデータに対して、次の3条件で5-fold層化交差検証(分類器はロジスティック回帰)の精度を測った。
- (A) 特徴選択リーク: 全データを使ってラベルとの相関の絶対値が大きい上位個の特徴を選び、その後で交差検証する。標準化はfold内で正しく行う
- (B) 正しいCV: 特徴選択も標準化も、交差検証の各foldの訓練側のデータだけで行う
- (C) 標準化リーク: 標準化(StandardScaler)だけを全データで先にfitし、特徴選択はfold内で正しく行う。「前処理を全データでやるリーク」の害の大きさを測る対照実験
条件(A)は、論文やKaggleカーネルで本当によく見る手順だ。「まず相関の高い特徴に絞ってから、交差検証で評価しました」——一見丁寧な仕事に見えるが、特徴を選ぶ段階でテストfoldになるはずのラベルまで見てしまっている。
これを、特徴数を100から100,000まで(対数で7段階)、選ぶ特徴数を10から1,000まで(5段階)振り、各セルで乱数シードを20個変えて平均した。
結果1: pを増やすほど、幻の精度は上がっていく
まず(上位10特徴を選ぶ)に固定して、特徴数を振った結果がこれだ。
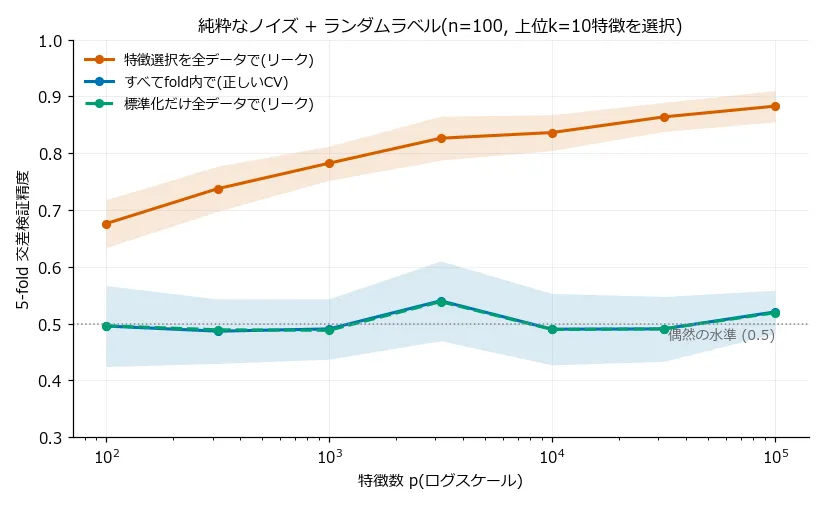
データは純粋な乱数なのに、リークあり(オレンジ)はの時点ですでに平均0.676。そしてを増やすほど幻の精度は上がり続け、では平均0.883(シードによっては0.93)に達した。一方、同じデータ・同じ分類器で選択をfold内に移しただけの正しいCV(青)は、全域で0.49〜0.52と偶然の水準に張り付いている。
「次元を増やすほど水増しがひどくなる」のは、偶然の相関の最大値がとともに伸びるからだ。次元の呪いを実測した回では高次元で距離が潰れる話をしたが、今回は同じ高次元が逆に「偶然の当たり」を大量に供給する側に回っている。1つの特徴とラベルの標本相関は、真の相関がゼロでもなら標準偏差約で揺らぐ。個の候補から最大値を取ると、その値はおよそで成長する——なら0.48程度の「見かけ上の強い相関」が偶然だけで出てしまう。全データで選択する手順は、この偶然の当たりくじを枚の中から探し出してくる作業に他ならない。
結果2: p×kのヒートマップに広がる「精度1.000」の領域
次にとの全組み合わせを見る。ここが今回一番驚いた結果だった。
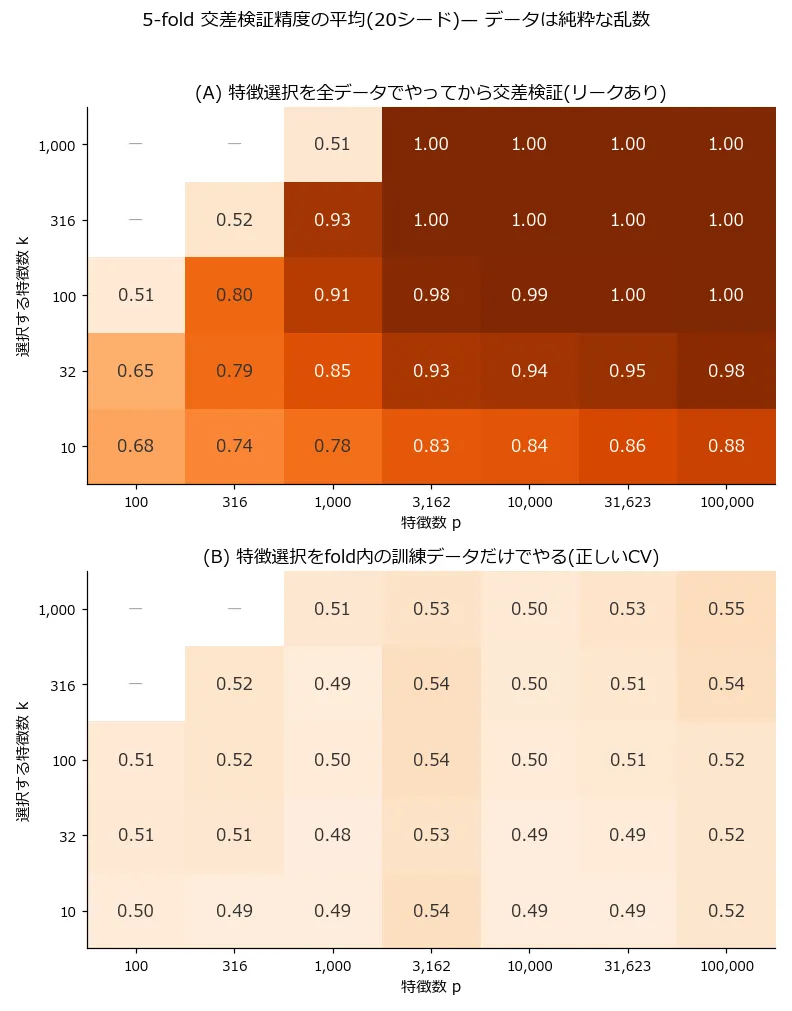
上のヒートマップ(リークあり)の右上、かつの領域では、交差検証精度が1.000——つまり100サンプル全問正解——になっている。のセルは、20シードのすべてで一度もミスなく1.000だった。もともと「精度90%が出てしまう」という想定でこの実験を始めたのだが、水増しは90%では止まらなかった。ただの乱数から、交差検証を(見かけ上)完璧に通過するモデルが安定して作れてしまう。
そしてもう1つ、このヒートマップには面白い「抜け」がある。となる対角のセル——つまり全特徴を選ぶ(=実質何も選択しない)場合——だけは、で0.505、で0.522、で0.511と、きれいに偶然の水準へ戻るのだ。リークの正体が「テストラベルを使った選別という行為」そのものであることが、この対角線にはっきり現れている。選別がなければ、同じ手順でも幻は生まれない。
結果3: 分布ごと見る — 正しいCVとリークの間に開いていく溝
シード平均だけでなく、60シードぶんの精度の分布そのものがとともにどう動くかもアニメーションにした(固定)。
の時点で、2つの山はすでに大きく離れている(リークあり側の60シードの最小値は0.59で、正しいCV側でそこに届いたのは60シード中7つだけ)。そしてが増えると、オレンジの山だけが右へ右へと滑っていく。では両者は1シードも重ならないところまで完全に分離し、リークありの精度は最悪のシードでも0.81、最良では0.96に達する(正しいCV側の最大は0.71)。「運悪くリークしても、たまたま低い精度が出て気づける」という救済はほぼ期待できないことが分布から読み取れる。
対照実験:標準化の影響は今回の設定では小さかった
「同じ数字を見ているのに結論が逆になる」という点ではSimpsonのパラドックスの回と同じ種類の罠だが、あちらが集計単位の問題だったのに対し、こちらは手順の順番だけで起きる。さて、リークと聞いてもう1つよく槍玉に挙がるのが「StandardScalerを交差検証の外でfitしてしまう」パターンだ。scikit-learnのドキュメントでもPipelineを使えと繰り返し警告される。では、その害は特徴選択リークとどのくらい違うのか。
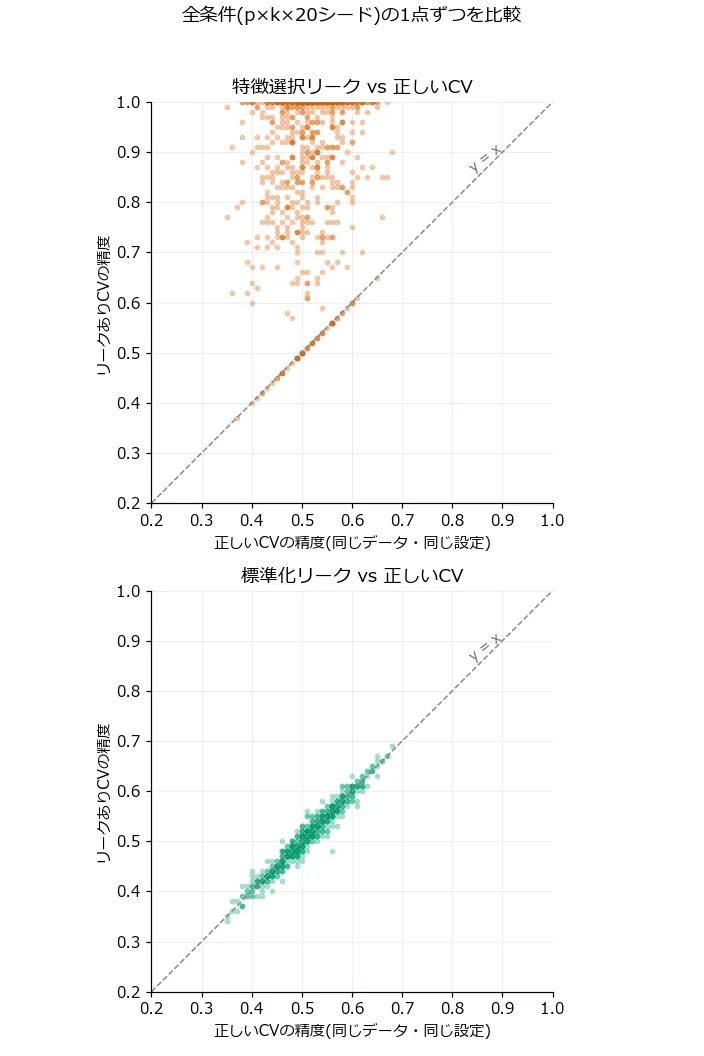
全640条件(p×k×20シード)で標準化リークあり/なしの精度差を取ると、平均+0.0001、差の標準偏差0.013、最大0.08だった。平均差は小さいが、「影響がないことを証明した」わけではない。特徴選択リークが同じ比較で平均+0.396(最大+0.64)の水増しを生んだのとは、規模が大きく違った。
今回の特徴は標準正規乱数で、全体と訓練foldの平均・分散が大きく違いにくい。一方、特徴選択では検証用のラベルそのものを使う。この違いが結果に表れていると考えられる。ただし、ラベルを使わなくても検証データの分布を先に知ることはリークになる。影響の大小を比べる話と、評価手順を正しく保つ話は分けたい。
手元のコードを直す:特徴選択も標準化もPipelineに入れる
以下は手順を示す最小例だ。本文の相関による選択を、2クラスの一変量検定f_classifで実装している。本文の20シード実験の数値をそのまま再現するコードではない。
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(42)
X = rng.normal(size=(100, 10_000))
y = rng.integers(0, 2, size=100)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

model = make_pipeline(
    SelectKBest(score_func=f_classif, k=100),
    StandardScaler(),
    LogisticRegression(max_iter=2000),
)
# 各foldの訓練側だけで選択・標準化・学習が行われる
scores = cross_val_score(model, X, y, cv=cv, scoring="accuracy")
print(scores, scores.mean())失敗するのは、SelectKBest(...).fit_transform(X, y)をこの交差検証の前に実行する形だ。scikit-learn公式のリーク解説も、分割後に前処理を学習し、Pipeline全体を評価する手順を示している。
さらに、特徴数kを何通りも試して一番高かったCV精度をそのまま報告すると、選んだ分の楽観的な偏りが残る。ネストした交差検証なら、内側で設定を選び、外側で評価できる。未使用のテストセットを最終評価に残す方法もある。同じ人の複数行や時系列データなら、Pipelineに加えて人単位・時間順の分割も必要になる。
正直に書いておくべきこと
- 正しいCVの精度も0.5ちょうどにはならない。 セル平均は0.483〜0.546の範囲で揺れた(全体平均0.511)。の交差検証1回の精度は標準偏差にして0.05前後揺らぐので、この程度のズレは期待通りの雑音だ。の行が軒並み0.53〜0.54と高めに見えるのも、同じ20個のデータセットをを変えて使い回しているため行内の値が相関しているせいで、意味のある構造ではない。
- 「標準化リークは無害」はこの設定での話。 特徴が行儀のよいガウス乱数で、分類器がスケールにほぼ不変なロジスティック回帰、という条件下の結果だ。裾の重い特徴や外れ値、がさらに小さい場合、あるいは目的変数を使う前処理(ターゲットエンコーディングなど)ではこの結論は使えない。今回の実験が示すのは「前処理リークが常に無害」ではなく、「リークの害はリークの種類によって桁違いに異なる」ことだ。
- 分類器はロジスティック回帰のみ、選択基準は相関のみ。 勾配ブースティングでの選択リークや、相互情報量ベースの選択などは測っていない。ただし水増しの主因は分類器ではなく「個の中から偶然の当たりを選べること」なので、傾向は大きくは変わらないと考えている(これは実測していない推測だ)。
- 交差検証の分割数(5-fold固定)やラベルの偏りの影響も振っていない。
手を動かして意外だったこと
一番の想定外は、水増しの上限だった。始める前は「乱数から精度90%が出たら記事になる」と思っていたのだが、実際には・の広い領域で精度は1.000に到達し、20シードの1つも欠けることなく全問正解が続いた。100サンプルを5つのfoldに分けて、どのfoldをテストにしても100発100中——リークした選別が作る「偶然の当たり特徴の寄せ集め」は、私が思っていたよりはるかに強力な暗記装置だった。
もう1つはの効き方だ。やる前は「選ぶ特徴を増やせば、1個あたりの偶然相関は弱くなるから水増しは薄まる」と直感していたが、逆だった。ではの0.883よりの1.000の方がひどい。弱い偶然相関でも、テストラベルを見て選ばれた特徴を316本束ねれば、ロジスティック回帰は完璧な暗記を組み上げてしまう。それでいてまで増やした瞬間に幻は消滅する。「選ぶ数を増やすほど悪化するが、全部選ぶと無害」という非単調な形は、ヒートマップを描いて初めて腹落ちした。
そして対照実験の標準化リークが、ここまで平均差の小さい結果になるとは思っていなかった。実験前は「特徴選択より小さいが、目に見える程度の水増しはあるだろう」と予想していたので、平均+0.0001という数字は予想と違った点として記録しておく。
まとめ
- n=100の純粋なガウス乱数と独立なランダムラベル(未知データでの精度の期待値は0.5)に対し、特徴選択を交差検証の外で行うと、5-fold CV精度はでも平均0.676、では0.883()に達した
- 選ぶ特徴数を増やすと水増しはさらに悪化し、・の領域では20シードすべてでCV精度1.000——乱数から全問正解のモデルが安定して作れた
- ただし(全特徴を選ぶ=選択しない)にすると精度は0.505〜0.522と偶然の水準に戻った。害の正体はテストラベルを使った「選別という行為」そのものだった
- 同じ設定で標準化リークの平均差は+0.0001と小さかった。ただし、標準化も訓練fold内で学習する原則は変わらない
- 幻の精度はとともにのペースで伸びる偶然相関の最大値に支えられており、「特徴が多いほど、リークしたときの見かけの成績はむしろ良くなる」——高次元データほど、この落とし穴は深くなる
関連記事
このブログでは、機械学習の仕組みを実際にコードで実装して確かめた実験をテーマ別に整理しています(拡散モデル・Transformer・強化学習・多様体学習・過学習など)。