
日本語のトークン数は英語の何倍? BPEを実装し、対訳では平均1.38倍だった
LLMの料金はトークン単位で決まる。そして「日本語は英語よりトークンを食うので高くつく」という話をよく聞く。実務でAPIを叩いていると無視できない話だが、実際どれくらいなのかを自分で測ったことがなかった。
そこで、トークナイザの中身であるBPE(Byte Pair Encoding)をゼロから実装し、仕組みを理解したうえで、自分のブログ49記事を実際のトークナイザにかけて測ってみた。結果は、よく言われる「3倍」という数字が半分正しくて半分ミスリードだという、思ったより面白いものだった。
実験に使ったコードの全文はGitHubに置いています。
BPEの仕組み: 頻出ペアを繰り返し合体させるだけ
BPEのアルゴリズムは驚くほど単純だ。テキストをバイト列にして、一番よく隣り合っているペアを1つの新しい記号に置き換える。これを語彙サイズの分だけ繰り返す。
for k in range(num_merges):
    pair, freq = get_stats(ids).most_common(1)[0]  # 最頻ペアを見つけて
    ids = merge(ids, pair, 256 + k)                # 新しいIDに置き換える
「低い 高い 高低差」の繰り返しで学習させると、最初はバイトの断片(今回の例の漢字・かなはUTF-8で各3バイトなので、まず文字を組み立てるところから)、やがて「高い」「低い 高い」のような意味のある単位が語彙として生まれてくる。言語の知識は一切与えていないのに、頻度統計だけで単語らしきものが浮かび上がるのが面白い。
UTF-8では、多くの漢字・かなが3バイトになる
そもそもBPEはバイト列から出発する。ここに最初の非対称がある。
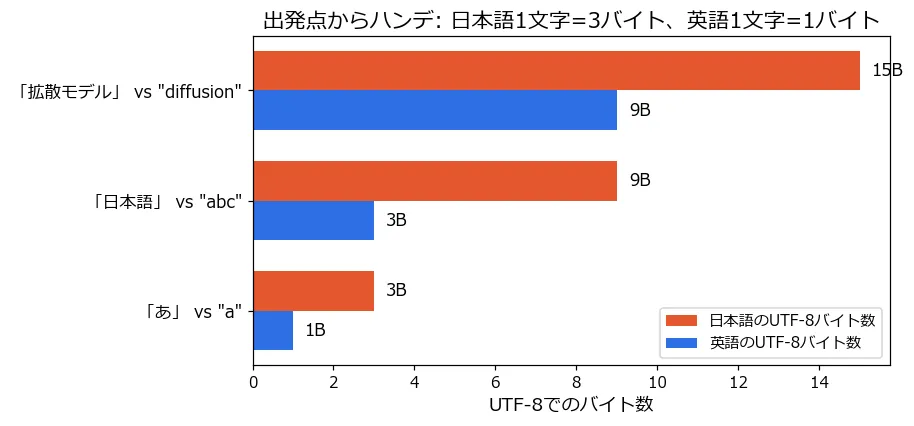
UTF-8ではASCIIの英字は1文字1バイト、多くの漢字・かなは1文字3バイトだ。ただし日本語文中にもASCIIや4バイトの文字などが混ざるため、すべての文字が3バイトではない。マージを始める前の時点で、日本語は3倍の長さの列から出発することになる。
自作BPEで測る: 語彙を増やしても差は縮まらない
自分のブログ49記事(12万字)と、比較用の英語テキスト(『不思議の国のアリス』を同じ文字数だけ)で、語彙サイズを変えながら圧縮率を測った。
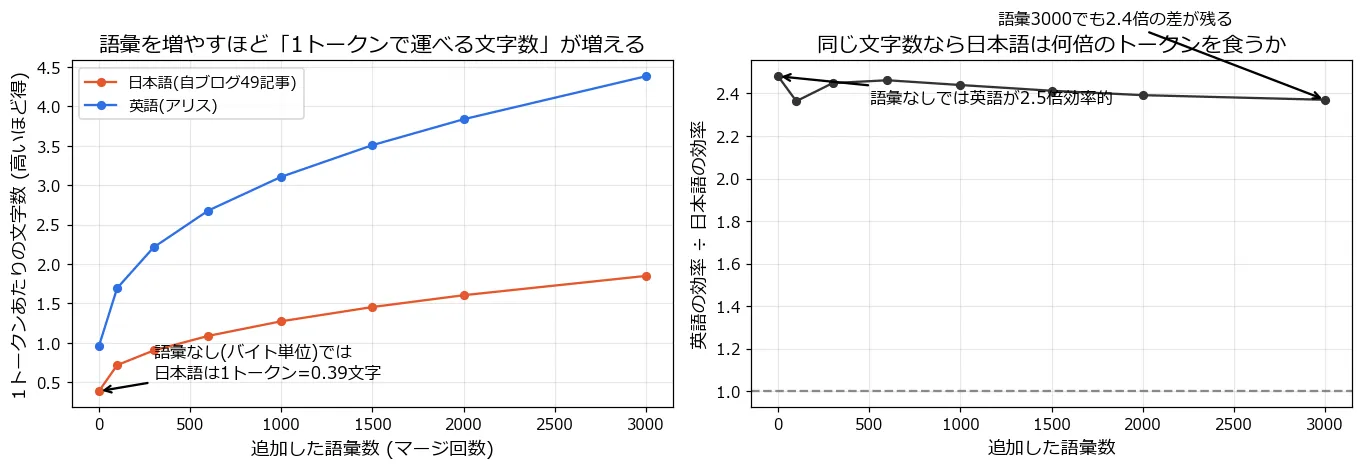
語彙を増やせばどちらも効率は上がる。だが両者の比は2.4倍前後のまま、ほとんど縮まらない。日本語は「文字を組み立てる」ためにまず語彙を消費してしまうので、単語レベルの圧縮に回せる余力が英語より少ないのだ。
実際のトークナイザで測る
自作BPEはおもちゃなので、本物(GPT-4o系のo200k_base)でも測った。
- 日本語(自ブログ12万字): 88,071トークン = 1.38文字/トークン
- 英語(アリス12万字): 31,070トークン = 3.93文字/トークン
- 同じ文字数なら、日本語は英語の2.83倍のトークンを消費
ちなみに一世代前のcl100k_base(GPT-3.5/4系)では日本語1.04文字/トークンで、比は3.75倍だった。新しいトークナイザで日本語の効率は3割ほど改善している——「日本語は3倍高い」という通説は、少し古い世代の数字なのだ。
ただし「同じ意味」で比べると1.38倍まで縮む
ここが今回いちばん面白かった点だ。文字数を揃えた比較はフェアではない。日本語の1文字は英語の1文字より多くの情報を運ぶからだ。そこで同じ内容の対訳ペアで測り直した。
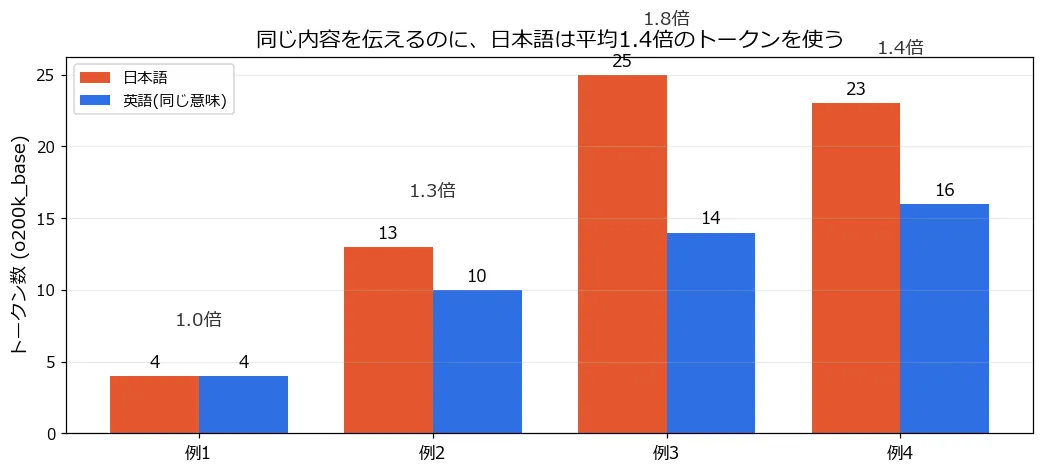
平均1.38倍。文字数ベースの2.83倍と比べると、半分以下だ。「こんにちは、世界。」と”Hello, world.”に至っては4トークンで同点である。
実際の分割を並べると、その差の正体が見える。
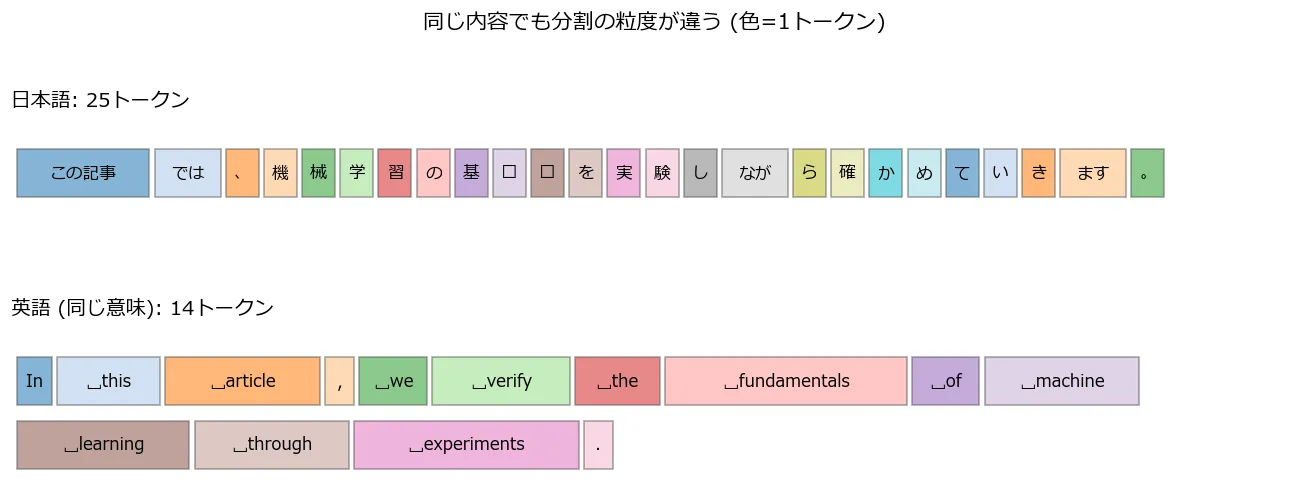
英語は単語がそのまま1トークンになる一方、日本語は「機」「械」「学」「習」と1文字ずつに砕けてしまう。ただし「この記事」「では」「ます」のように、頻出する塊はちゃんと1トークンに圧縮されている。日本語は不利だが、言われるほど絶望的でもない。
12万字を入力した場合の料金例(入力単価を仮に$3/100万トークンと置いた試算で、現行モデルの料金表ではない)は日本語$0.264 / 英語$0.093。同じ文字数なら約2.8倍だが、今回の対訳サンプルではトークン数が平均1.38倍だった。同じ意味の文章でも訳し方や分野、トークナイザによって比は変わり、APIの請求額全体の比率を表すわけではない。
手を動かして意外だったこと
「日本語は3倍高い」を検証するつもりが、何と比べるかで答えが2.83倍にも1.38倍にもなるという、比較の設計そのものの話になった。文字数を揃えた比較は一見公平だが、実際には「同じ文字数でより多くを語れる」という日本語の性質を無視している。ベンチマークの数字を読むときは、揃えているものが本当に揃えるべきものかを疑うべきだ——Datasaurusの回から続く「数字は嘘をつかないが、何を測っているかは別問題」の系譜に、また1つ実例が増えた。
もう1つは、トークナイザが世代交代で日本語に優しくなっていること(3.75倍→2.83倍)。ただし、この測定だけで学習コーパスや語彙配分の設計意図までは分からない。ここで確認できたのは、今回の日本語文がo200k_baseでは少ないトークンで表されたことだ。
「日本語の文字数÷1.4」は今回のブログ本文での概算にすぎない。実務では対象モデルのトークナイザで実際のプロンプトを数える。tiktokenの公式リポジトリにはモデルに対応するエンコーディングを選ぶ方法がある。英訳でトークンを減らせても、回答品質や出力長まで同じとは限らないので、費用と品質を一緒に比較したい。
まとめ
- BPE(頻出バイトペアを繰り返し合体させる圧縮)をゼロから実装。言語知識ゼロでも頻度統計だけで単語らしき語彙が生まれる
- 出発点の非対称: UTF-8で多くの漢字・かなは3バイト、ASCIIの英字は1バイト
- 自作BPEでの測定: 語彙を3000まで増やしても、英語と日本語の効率比は2.4倍前後で横ばい
- 実トークナイザ(o200k_base)で自ブログ12万字を測定: 日本語1.38文字/トークン vs 英語3.93文字/トークン = 同じ文字数なら2.83倍。ただし旧世代のcl100k_baseでは3.75倍で、新トークナイザは日本語に3割優しくなっている
- 同じ意味の対訳で比べると差は平均1.38倍まで縮む。この比率は今回のサンプルとトークナイザでの値で、日本語全体に一律の倍率があるわけではない
関連記事
このブログでは、機械学習の仕組みを実際にコードで実装して確かめた実験をテーマ別に整理しています(拡散モデル・Transformer・強化学習・多様体学習・過学習など)。